Cách Cài Ollama Trên VPS Làm Trợ Lý AI, Tiết Kiệm Phí API A-Z
Cài Ollama trên VPS là kỹ năng bạn cần nếu muốn chạy các mô hình ngôn ngữ lớn (LLM) ngay trên hạ tầng của mình, thay vì trả phí API đều đặn hoặc bị hạn chế bởi dịch vụ bên thứ ba. Nỗi đau ở chỗ: nhiều người mất cả ngày vì lỗi thiếu dependency, […]
 Thanh Lam Nguyễn15 phút đọc
Cài Ollama trên VPS là kỹ năng bạn cần nếu muốn chạy các mô hình ngôn ngữ lớn (LLM) ngay trên hạ tầng của mình, thay vì trả phí API đều đặn hoặc bị hạn chế bởi dịch vụ bên thứ ba. Nỗi đau ở chỗ: nhiều người mất cả ngày vì lỗi thiếu dependency, service không tự khởi động hay model bị Killed giữa chừng. Bài viết dưới đây sẽ dẫn bạn đi qua toàn bộ quy trình từ chuẩn bị cấu hình, cài đặt Ollama trên VPS chỉ bằng 4 bước, chạy model đầu tiên cho tới xử lý các lỗi phổ biến — nếu chưa có máy chủ riêng, bạn có thể bắt đầu với một gói VPS giá rẻ của ThueVPSGiaRe.vn để thực hành ngay hôm nay.
1. Ollama là gì và vì sao nên tự host trên VPS?
Ollama là một nền tảng mã nguồn mở mạnh mẽ, cho phép bạn thiết lập, vận hành và quản lý trực tiếp các mô hình ngôn ngữ lớn (LLM) ngay trên máy tính cá nhân hoặc máy chủ riêng biệt. Thay vì phụ thuộc vào các dịch vụ đám mây bên thứ ba vốn tiềm ẩn nguy cơ bảo mật, Ollama đơn giản hóa toàn bộ quá trình đóng gói và tối ưu hóa tài nguyên phần cứng để mô hình AI chạy mượt mà thông qua giao diện dòng lệnh hoặc API cục bộ.
- Bảo mật dữ liệu tuyệt đối: Toàn bộ dữ liệu nhập xuất (prompt/output) chỉ lưu hành trong phạm vi máy chủ nội bộ, rất phù hợp cho doanh nghiệp xây dựng trợ lý ảo chuyên sâu.
- Tiết kiệm ngân sách vận hành: Không bị tính phí theo từng token như các dịch vụ trả phí; bạn có thể tận dụng một máy chủ ổn định để truy vấn không giới hạn số lượng request.
- Dễ dàng mở rộng kết nối: Ollama cung cấp sẵn endpoint tương thích chuẩn RESTful API, giúp kết nối nhanh chóng vào các pipeline tự động hóa hoặc giao diện web.
2. Yêu cầu phần cứng và chuẩn bị môi trường VPS Linux
Việc chạy các mô hình AI cục bộ đòi hỏi máy chủ ảo phải đáp ứng cấu hình tối thiểu nhất định nhằm tránh trường hợp tràn bộ nhớ hoặc nghẽn xung nhịp vi xử lý. Trước khi tiến hành cài đặt, bạn nên đối chiếu tài nguyên máy chủ với các tiêu chuẩn kỹ thuật dưới đây:
- Dung lượng RAM: Tối thiểu từ 16GB RAM để xử lý mượt mà các mô hình thông dụng như DeepSeek-R1 (bản 7B/8B) hay Llama 3; nếu muốn chạy model đa tham số lớn hơn, cần chuẩn bị từ 32GB RAM trở lên. Bạn có thể tham khảo thêm hướng dẫn khả năng chạy tool của gói VPS 8GB RAM trước khi quyết định mức dung lượng phù hợp cho ứng dụng của mình.
- Năng lực CPU: Yêu cầu tối thiểu từ 4 Core đến 8 Core vi xử lý để thực thi các tác vụ tính toán vector trên tập lệnh AVX2 khi chạy chế độ CPU thuần túy.
- Không gian lưu trữ: Tối thiểu 12GB đến 50GB dung lượng trống trên ổ cứng thể rắn chuẩn ổ cứng SSD NVMe tốc độ cao để tải và lưu trữ trọng số mô hình đã lượng hóa mà không gặp hiện tượng nghẽn I/O.
- Hệ điều hành hỗ trợ: Khuyến nghị dùng hệ điều hành bản phân phối Ubuntu Linux từ phiên bản 22.04 LTS trở lên, hoặc các phiên bản Debian ổn định mới nhất.
- Đặc quyền hệ thống: Bạn bắt buộc phải nắm tài khoản có toàn quyền root hoặc một user đã được phân quyền quản trị trong nhóm sudo.
3. Hướng dẫn các bước cài đặt Ollama trên VPS Linux chi tiết
Quy trình cài đặt Ollama thủ công trên môi trường Linux rất trực quan và chỉ mất từ 3 đến 5 phút để hoàn tất. Bạn chỉ cần mở cửa sổ dòng lệnh và thực hiện tuần tự theo các bước chuẩn xác sau:
Bước 1: Cập nhật chỉ mục kho lưu trữ hệ điều hành
Trước khi tải thêm bất kỳ gói phần mềm nào, hãy đảm bảo hệ thống Ubuntu của bạn đã được cập nhật bản vá mới nhất để tránh xung đột thư viện:
sudo apt update && sudo apt upgrade -y
Bước 2: Cài đặt các gói phụ thuộc cần thiết
Ollama và các mô hình mở rộng yêu cầu môi trường sẵn có các công cụ như Python 3, trình quản lý gói pip, công cụ cURL và Git. Bạn thực thi câu lệnh sau trên terminal:
sudo apt install -y python3 python3-pip git curl
Sau khi quá trình kết thúc, bạn có thể kiểm chứng phiên bản cài đặt thành công bằng cách gõ:
python3 --version
pip3 --version
git --version
Lưu ý: Trong trường hợp VPS của bạn được trang bị card đồ họa rời NVIDIA GPU, bạn cần cài đặt thêm gói CUDA Toolkit chính thức từ hãng để kích hoạt tăng tốc phần cứng. Nếu sử dụng VPS CPU tiêu chuẩn, Ollama sẽ tự động nhận diện và tính toán dựa trên tập lệnh CPU tương thích.
Bước 3: Tải và thực thi script cài đặt Ollama chính thức
Đội ngũ phát triển Ollama cung cấp sẵn một đoạn mã cài đặt tự động tương thích với các nhân Linux. Bạn sử dụng công cụ curl để tải và cấp quyền thực thi chỉ với một câu lệnh duy nhất:
curl -fsSL https://ollama.com/install.sh | sh
Script sẽ tự động nhận diện cấu hình kiến trúc CPU (x86_64 hoặc ARM64), tải binary tương ứng và phân bổ vào thư viện hệ thống. Sau khi màn hình hiển thị hoàn tất, hãy kiểm tra lại bằng lệnh:
ollama --version
4. Cấu hình Ollama chạy ngầm bằng systemd và mở cổng truy cập
Mặc dù bạn có thể chạy thử trực tiếp trên dòng lệnh bằng lệnh ollama serve, nhưng để máy chủ AI duy trì hoạt động 24/7 và tự động phục hồi khi khởi động lại VPS, cấu hình systemd service là phương án bắt buộc.
Trước hết, hãy kiểm tra xem tiến trình nền đã được hệ thống tự kích hoạt chưa:
systemctl status ollama
Mặc định, Ollama chỉ cho phép kết nối nội bộ từ 127.0.0.1 trên cổng 11434. Để kết nối với ứng dụng bên ngoài hoặc công cụ chạy trên máy tính khác, chúng ta cần mở cổng và lắng nghe trên dải IP 0.0.0.0. Hãy mở file cấu hình dịch vụ systemd bằng trình soạn thảo nano:
sudo nano /etc/systemd/system/ollama.service
Thiết lập nội dung chi tiết cho file dịch vụ như sau:
[Unit]
Description=Ollama Service
After=network.target

[Service]
ExecStart=/usr/local/bin/ollama --host 0.0.0.0 --port 11434
Restart=always
User=root

[Install]
WantedBy=multi-user.target
Lưu file lại (nhấn tổ hợp phím Ctrl + O, nhấn Enter và thoát bằng Ctrl + X). Sau đó, bạn cần nạp lại cấu hình daemon của hệ điều hành và khởi động lại dịch vụ:
sudo systemctl daemon-reload
sudo systemctl restart ollama
sudo systemctl enable ollama
Nếu trên máy chủ của bạn đang bật tường lửa, đừng quên tham khảo hướng dẫn thiết lập tường lửa UFW chuẩn kỹ thuật để mở đúng cổng 11434 một cách an toàn mà không để lộ các dịch vụ quản trị nhạy cảm khác.
5. Khởi chạy model đầu tiên và tổng hợp lệnh Ollama CLI cần biết
Sau khi hoàn tất quá trình cài đặt, bạn có thể tương tác trực tiếp với các mô hình ngôn ngữ lớn ngay trên giao diện dòng lệnh. Lệnh ollama run sẽ tự động kiểm tra mô hình trong máy chủ; nếu chưa có sẵn, hệ thống sẽ tự pull về và mở phiên chat tức thì.
Các lệnh tải và khởi chạy mô hình phổ biến
# Tải và chạy thử mô hình DeepSeek-R1 (bản 8B tối ưu cho môi trường VPS vừa và nhỏ)
ollama run deepseek-r1:8b

# Tải trước mô hình Llama 3.3 mà không cần mở giao diện chat
ollama pull llama3.3

# Tải mô hình Qwen 2.5 hoặc Gemma 2 dung lượng 7B
ollama pull qwen2.5:7b
Bảng tổng hợp các lệnh quản trị tài nguyên mô hình
| Lệnh thao tác | Mục đích sử dụng |
|---|---|
| ollama list | Hiển thị danh sách các model đã tải về ổ cứng kèm dung lượng lưu trữ tương ứng. |
| ollama ps | Xem chi tiết các mô hình đang nạp trên RAM/VRAM và tỷ lệ tài nguyên CPU đang chiếm dụng. |
| ollama rm <tên-model> | Xóa hoàn toàn model được chỉ định để giải phóng dung lượng ổ đĩa. |
| ollama show <tên-model> –modelfile | Xem thông số cấu hình gốc, template câu lệnh, tham số temperature và system prompt của model. |
6. Kết nối Ollama với Open WebUI, n8n và kiến trúc AI Agent
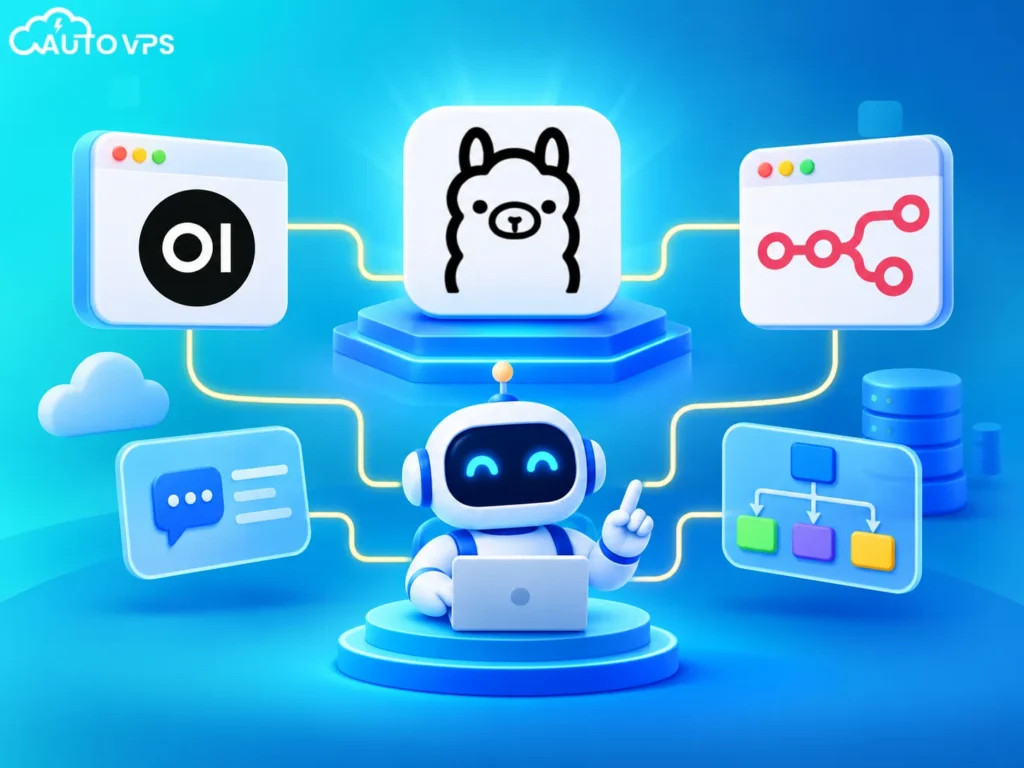
Việc sử dụng giao diện CLI chỉ phù hợp cho nhu cầu kiểm thử kỹ thuật đơn giản. Để ứng dụng vào công việc thực tế, người dùng thường dựng giao diện trực quan tương tự ChatGPT hoặc gắn vào các luồng tự động hóa công việc.
Việc triển khai các ứng dụng này trở nên thuận tiện hơn bao giờ hết khi bạn đã hiểu rõ công nghệ đóng gói ứng dụng Docker để cô lập môi trường vận hành an toàn.
Dựng giao diện chat Open WebUI với Docker
Để triển khai một giao diện trực quan thân thiện kết nối trực tiếp đến backend Ollama đang chạy trên máy chủ, bạn chỉ cần thực thi câu lệnh Docker sau:
docker run -d -p 3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:main
Sau khi khởi chạy container, bạn có thể truy cập vào địa chỉ http://IP_VPS:3000 để trải nghiệm giao diện trò chuyện đa tính năng. Bạn cũng có thể xem thêm bài hướng dẫn cài đặt Open WebUI trên hệ điều hành Ubuntu để biết cách cấu hình người dùng và quản lý quyền truy cập một cách bài bản.
Tích hợp Ollama vào chuỗi tự động hóa với n8n
Bên cạnh giao diện tương tác, mô hình Ollama trên máy chủ Linux là thành phần hạ tầng lý tưởng khi xây dựng các AI Agent thực hiện các tác vụ trích xuất, phân tích dữ liệu chuyên sâu. Bạn hoàn toàn có thể kết hợp nền tảng này bằng cách theo dõi quy trình thiết lập công cụ tự động hóa n8n qua Docker. Khi đó, n8n sẽ gọi vào cổng 11434 của Ollama như một local LLM node bảo mật, xử lý văn bản tự động mà không lo phát sinh chi phí token API hàng tháng.
7. Xử lý các lỗi thường gặp trong quá trình vận hành Ollama
Trong quá trình vận hành các mô hình ngôn ngữ lớn trên môi trường Linux, bạn có thể bắt gặp một số tình huống lỗi tài nguyên hoặc xung đột tiến trình sau:
1. Ollama không nhận diện được GPU NVIDIA (Chỉ chạy CPU)
Hiện tượng này xảy ra khi Ollama ghi nhận GPU discovery thất bại. Nguyên nhân thông thường do thiếu thư viện CUDA tương thích trong biến môi trường hoặc driver chưa được nạp chính xác. Bạn có thể kiểm tra nhật ký log hệ thống thông qua cú pháp:
journalctl -u ollama --no-pager -e
Nếu muốn ép buộc hệ thống chạy chế độ CPU tối ưu instruction set AVX2 (trong trường hợp driver bị xung đột), bạn có thể gán thêm biến môi trường: OLLAMA_LLM_LIBRARY="cpu_avx2" vào file cấu hình dịch vụ.
2. Lỗi cổng 11434 bị chiếm dụng (bind: address already in use)
Lỗi này xuất hiện khi bạn gõ lệnh ollama serve thủ công trong khi tiến trình nền của systemd service đã tự khởi chạy ngầm. Hãy kiểm tra dịch vụ nào đang chiếm dụng cổng mạng:
sudo ss -tulpn | grep 11434
Nếu service ollama đang chiếm giữ, hãy quản trị thông qua systemctl thay vì chạy lệnh tay:
sudo systemctl restart ollama
3. Tiến trình bị tắt đột ngột (Killed / Out of Memory)
Khi bạn cố gắng nạp một mô hình vượt quá ngưỡng RAM vật lý khả dụng của server, trình quản lý Linux OOM Killer sẽ tự động ngắt tiến trình Ollama để bảo vệ hệ thống. Giải pháp xử lý ngay là chủ động tham khảo bài viết cách khởi tạo bộ nhớ ảo Swap trên Linux để bổ sung từ 8GB – 16GB bộ đệm cho ổ cứng, hoặc chuyển sang dùng bản model có dung lượng nhỏ hơn (ví dụ chuyển từ 14B về 8B hoặc 3B).
4. Lỗi tải model bị ngắt quãng hoặc đầy ổ cứng root
Nếu phân vùng / của hệ điều hành bị đầy, lệnh pull sẽ lập tức báo lỗi disk full. Bạn có thể giải quyết nhanh bằng cách trỏ biến môi trường OLLAMA_MODELS sang một phân vùng ổ cứng mở rộng có dung lượng lớn hơn.
8. So sánh VPS tiêu chuẩn và Cloud Server khi tự host Ollama
Nhiều người phân vân không biết nên chọn máy chủ ảo VPS hay hạ tầng Cloud Server khi bắt đầu triển khai Ollama trên Linux. Bảng so sánh dưới đây phân loại chi tiết theo nhu cầu và mục tiêu thực tế của dự án:
| Tiêu chí hạ tầng | VPS Linux (Tiêu chuẩn) | Cloud Server (Doanh nghiệp) |
|---|---|---|
| Mục đích sử dụng | Môi trường dev/test, dự án cá nhân, chatbot nội bộ nhóm nhỏ. | Môi trường production, hệ thống chịu tải cao, xử lý song song nhiều kết nối. |
| Model đề xuất | Chạy tốt các model 3B, 7B, 8B (lượng hóa chuẩn 4-bit Q4). | Đáp ứng tốt các model nặng từ 14B, 32B đến 70B đa tham số. |
| Khả năng co giãn | Cấu hình cố định theo gói tài nguyên đã đăng ký ban đầu. | Nâng vCPU và RAM linh hoạt nhanh chóng khi tải nghiệp vụ tăng cao. |
| Chi phí vận hành | Chi phí tiết kiệm, tối ưu cho freelancer và lập trình viên độc lập. | Mức đầu tư chuyên nghiệp tương xứng với hiệu năng và độ ổn định cao. |
9. Câu hỏi thường gặp (FAQ)
VPS không có GPU thì Ollama có chạy được không?
Có. Ollama hỗ trợ cơ chế suy luận hoàn toàn bằng CPU với sự trợ giúp của tập lệnh AVX2. Đối với các model từ 7B đến 8B được lượng hóa 4-bit (Q4), hệ thống vẫn đem lại tốc độ phản hồi khá ổn định cho nhu cầu thử nghiệm và tích hợp quy trình tự động.
Làm thế nào để đổi cổng mặc định 11434 của Ollama?
Bạn chỉ cần chỉnh sửa file dịch vụ systemd tại đường dẫn /etc/systemd/system/ollama.service, thay đổi tham số --port <cổng_mới> tại dòng ExecStart, sau đó thực hiện lệnh sudo systemctl daemon-reload và khởi động lại dịch vụ.
Lưu trữ của Ollama nằm ở đâu trên hệ thống Linux?
Mặc định trên Linux, toàn bộ trọng số mô hình tải về sẽ được lưu tại thư mục /usr/share/ollama/.ollama/models. Nếu muốn chuyển sang phân vùng khác, bạn hãy thiết lập biến môi trường OLLAMA_MODELS="/duong/dan/moi" trong file cấu hình dịch vụ.
Tổng kết quy trình cài đặt và làm chủ Ollama trên máy chủ ảo
Thực hiện đúng hướng dẫn cách cài Ollama trên VPS không chỉ giúp bạn làm chủ một hệ sinh thái trí tuệ nhân tạo riêng tư mà còn tối ưu hóa chi phí vận hành lâu dài. Để hệ thống đạt hiệu suất cao và hoạt động bền bỉ, hãy lưu ý ba điểm then chốt: chuẩn bị cấu hình RAM từ 16GB trở lên, thiết lập systemd service chạy ngầm ổn định và kết hợp bộ nhớ đệm Swap để chống tràn RAM khi nạp model.
Cần một VPS giá rẻ để bắt đầu?
Chọn cấu hình vừa đủ nhu cầu, ưu tiên chi phí dễ tiếp cận và khả năng quản trị riêng.
Lưu ý kỹ thuật: Toàn bộ thông tin và các câu lệnh cấu hình trong bài viết chỉ mang tính tham khảo kỹ thuật. Các tham số, đường dẫn và mức tiêu thụ tài nguyên thực tế có thể thay đổi tùy thuộc vào phiên bản hệ điều hành Linux cũng như các bản cập nhật phần mềm tiếp theo. Bạn nên chủ động kiểm thử, tạo bản sao lưu dữ liệu và kiểm soát rủi ro trước khi triển khai trực tiếp vào môi trường production.